Query 驱动的 Analyzer–Checker 双阶段评估
四个独立评估器统一采用 Analyzer–Checker 架构。结合任务 Query,以前页—当前页—后页组成三页滑动窗口逐页评估;Analyzer 发现问题,Checker 复核,输出问题证据与严重程度,并加权汇总质量评分。
AI / Agent 算法方向
电子科技大学 · 计算机科学与工程学院

以线上用户负反馈为起点,设计由 Trace 归因驱动的 Agent 自进化机制,从执行路径差异中提炼可复用的优化策略。以 Word 文档生成为应用场景,结合文档产物评估与固定基准,验证优化收益、检查能力回退。
从线上负反馈进入训练题,到双路径归因、候选 Skill 更新,再到固定基准验证与跨轮规则审计,查看各环节如何连接。
查看交互完整版
完整流程预览 · 交互功能准备好后自动显示
采用跨模型对比与自身高低分自对比两条路径:前者向强模型学习,后者比较同一模型的不同执行结果,从执行路径差异中提取可迁移的候选优化点。
对跨 Case 候选改动点去重合并,归纳共性并处理规则冲突。检查跨 Case 证据、策略可迁移性及题目信息泄漏,仅将通过门禁的通用策略纳入候选 Skill 版本。
对进化前后的 Trace 进行同 Case 配对分析,识别有效、有害、执行未遵循及冗余规则,将审计结果带入后续轮次,驱动规则强化、精简或回退。
在归纳阶段,逐项检查候选规则的证据、泛化能力与一致性;任一项不通过,即淘汰该候选。
有多少失败样本支持这条规则,是否只是一次偶发失误。
多份文档都漏查了后续页面,才为“检查全部页面”提供共同证据;仅一份文档出错,还不足以直接推广。
能否解释多种独立失误,找到它们背后的共同问题。
漏看后续页、漏查后续表格、只验正文不验附录,表现不同,却都指向“检查范围不完整”,可归纳为全覆盖核验规则。
对照本轮否决记录,避免同一个问题换种说法又被接受。
“只检查第一页”已因漏检被否决,改写成“验完首页即可结束”仍是同一做法,不能重新放行。
不把具体题目的输入、答案、ID 或专属数据写进规则。
不能写“这份周报的总额应改成 128 万”;应提炼为“汇总金额须与明细逐项核对”,让模型学会方法。
换掉具体名称或对象后,规则是否仍然成立。
把“销售报表”换成“库存报表”,“逐项核对明细与汇总”仍然适用;若换个名称就失效,规则可能只针对原题。
面对训练记录里没出现过的同类新任务,能否指导执行。
旧任务只有单张表,新任务包含多张工作表。“先列全核验范围,再逐项检查”仍能指导处理,才具备覆盖新任务的可能。
强模型的成功过程,能否写成弱模型也能执行的步骤。
“先渲染文档,再逐页检查布局”是可复制的流程;强模型直接凭推理得出答案,却没有可复现步骤,就不能据此写规则。
对照当前 Skill,避免新增要求与已有约束互相冲突。
已有规则要求“保留用户模板样式”,就不能新增“所有文档强制统一字体”;必须先明确适用条件、消除冲突。
规则正文只保留通用要求,例子与占位示意放在证据说明中。
正文写“交付前逐页核验表格完整性”;“例如某客户月报……”这类演示留在证据说明里,不追加进 Skill 正文。
四个独立评估器统一采用 Analyzer–Checker 架构。结合任务 Query,以前页—当前页—后页组成三页滑动窗口逐页评估;Analyzer 发现问题,Checker 复核,输出问题证据与严重程度,并加权汇总质量评分。
以人工标注文档作为 GT,问题识别准确率、召回率分别达到 88.0% / 81.2%。对同一评估器进行 ×5 次重复评测,将评估结果翻转率由 16.3% 降至 3.9%。
基于自动化产题链路持续构建训练题,人审通过率超过 90%后转入自动化产题,使题库随线上问题持续更新;通过重复试跑检验稳定性与区分度,为归因迭代提供训练题。
人工校正候选题的任务输入与执行配置,结合试跑结果调整典型问题覆盖,并补充 Good Case,形成固定基准,统一检验候选版本的优化收益与能力回退。
完成 16 轮 Skill 进化,在人工金标基准与线上真实 Query 中验证效果。

随着 Agent Skill 库持续增长,如何从大量语义相近、功能重叠的技能中,准确且高效地选择适合当前任务的 Skill,成为技能复用的关键问题。
随着 Skill 库从百级扩到万级,Top-K 候选会越来越集中在同一个语义邻域里。传统逐点打分只能回答“它和 query 像不像”,却很难回答“这几个都很像时到底谁更对”。
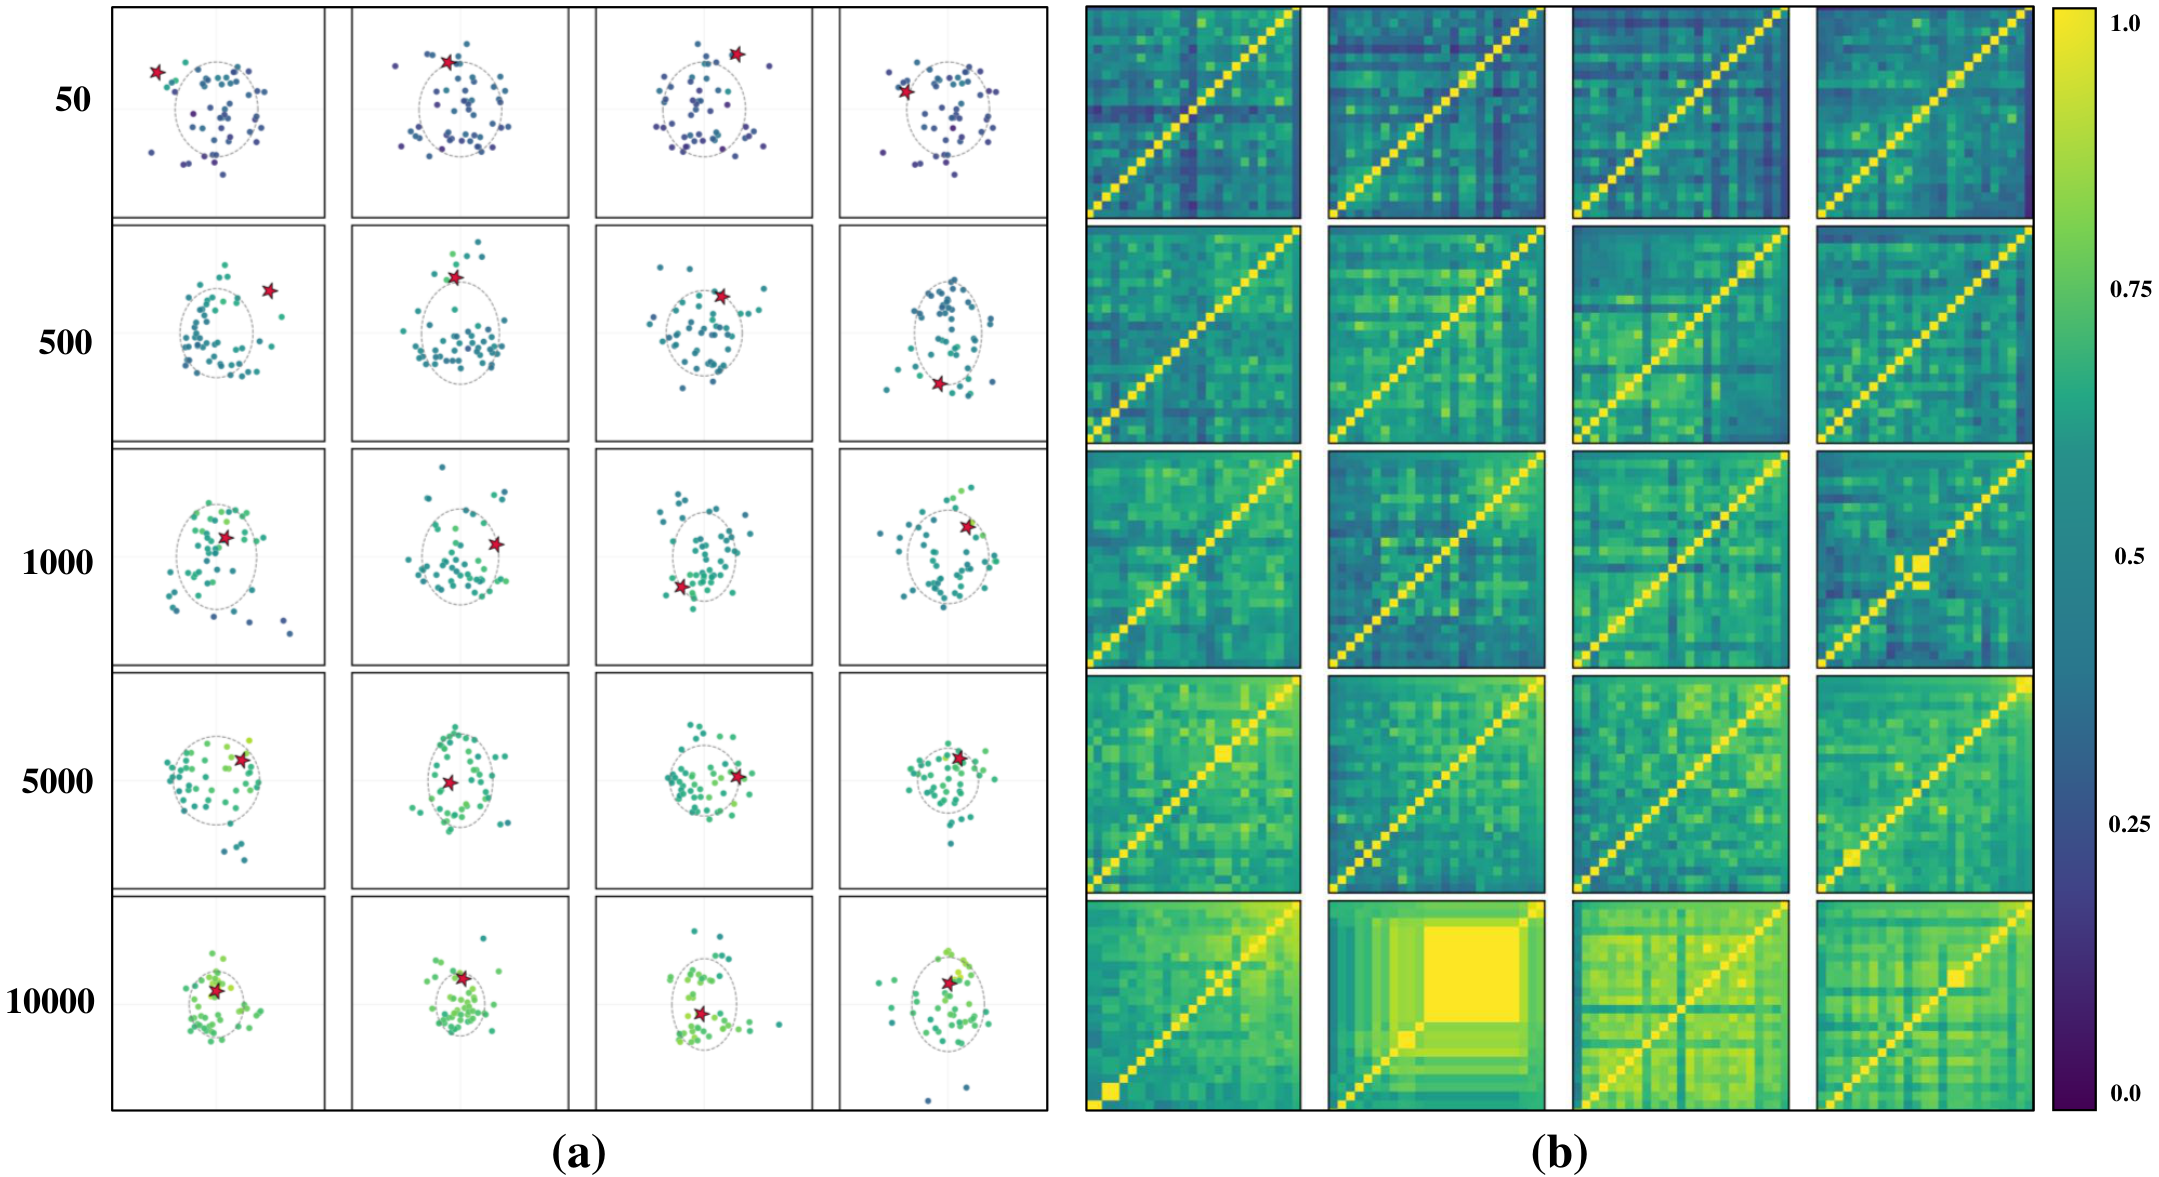
基于相似度的 RAG 检索采用 pointwise 打分,分别计算 Query 与每个 Skill 的相似度,再进行排序,缺少候选之间的直接比较。
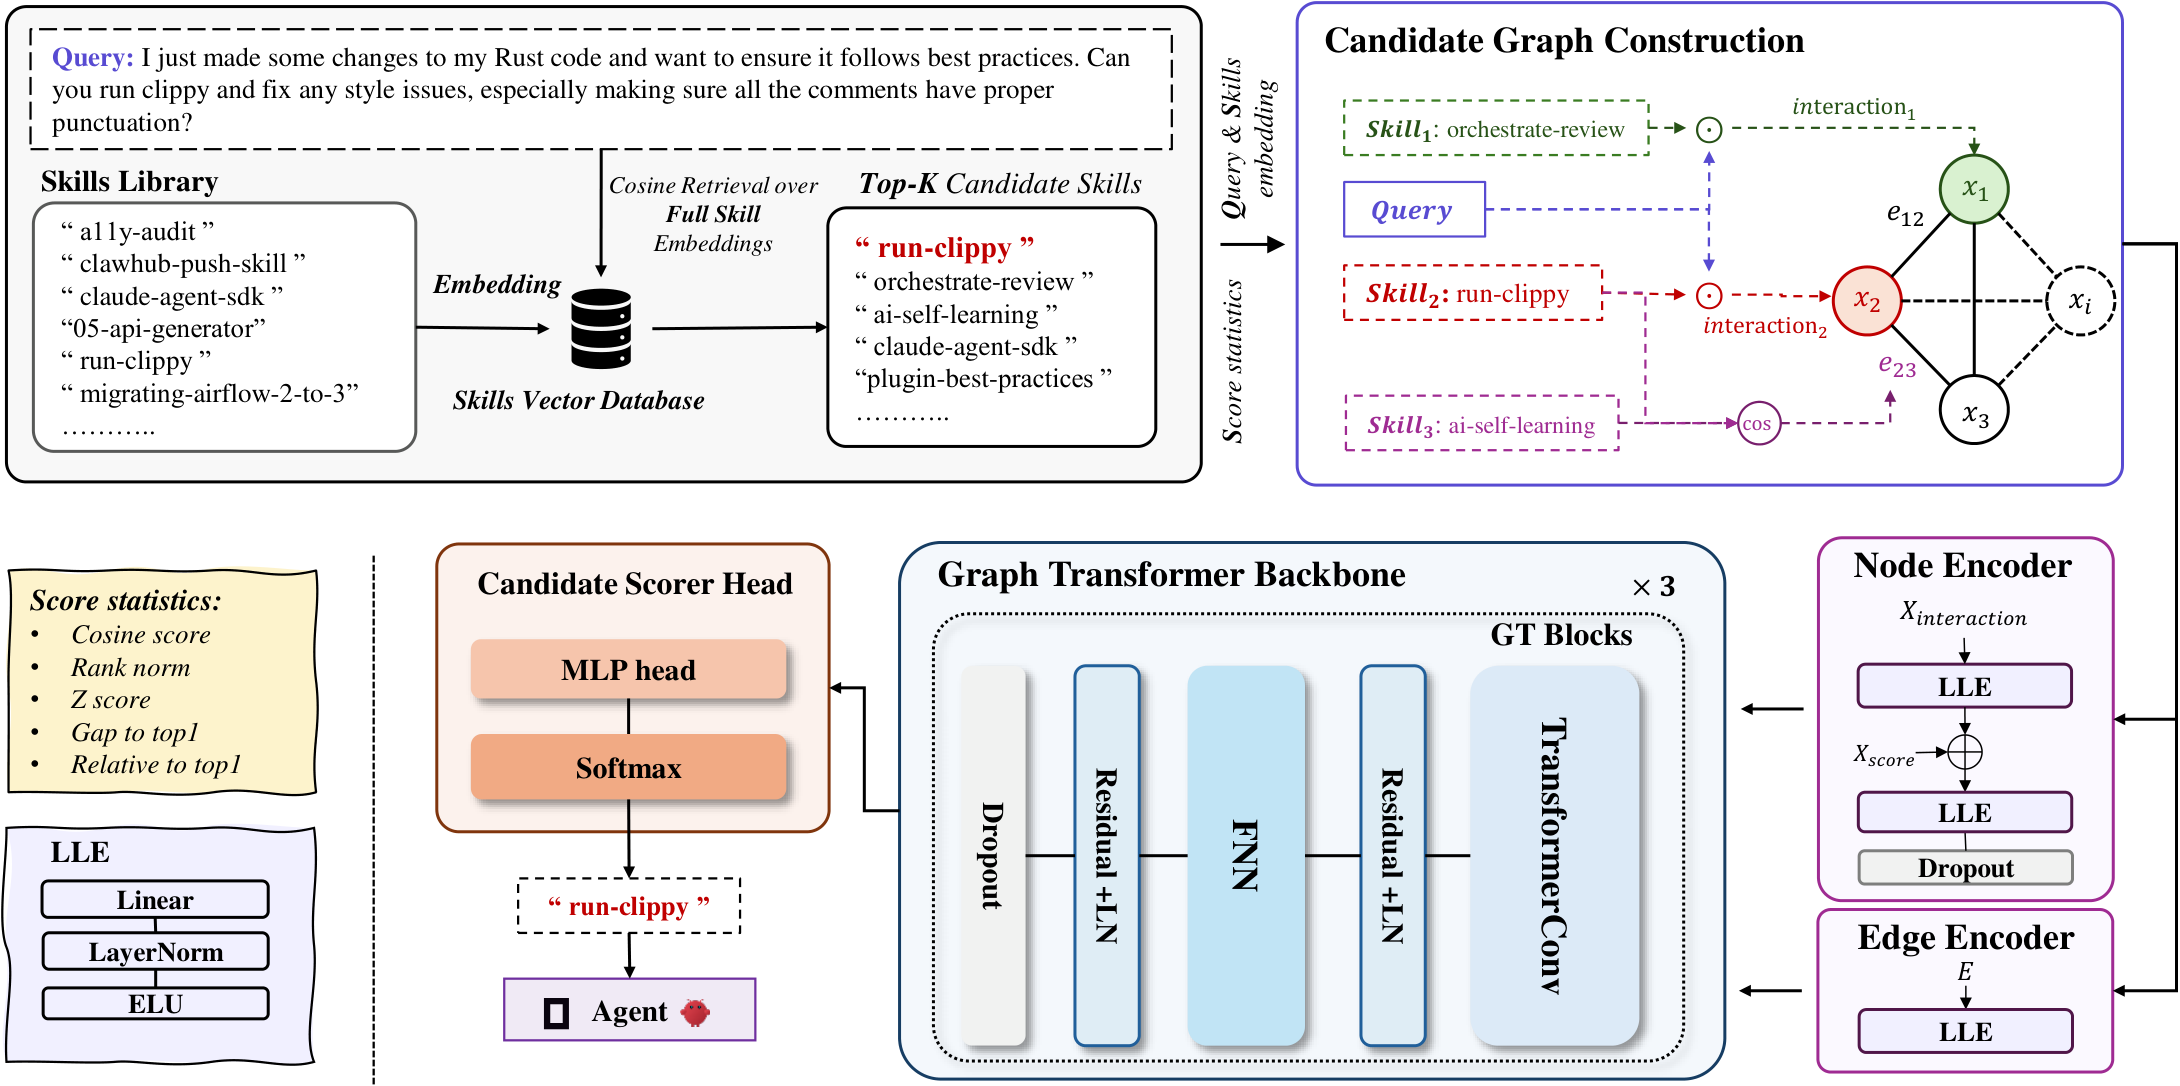
不能只看一个候选与任务有多相关,还要判断其他相近候选是否更合适。因此,我们将候选放在一起建模,让评分同时考虑自身匹配程度和其他候选的匹配情况。
将召回的 Top-K Skill 构建成图:节点表示候选 Skill,包含 Query–Skill 匹配信息与检索统计量;边表示候选 Skill 之间的相似关系。通过 GNN 在节点间传递信息,引入候选之间的比较与竞争,完成联合重排。
构建了包含 16,208 个真实 Agent 技能的测试库(严格剔除低活跃(Stars 低于 1000)及结构残缺的低质数据)。同时,借助 GPT-5.4 生成并深度清洗了 20,500 条测试指令,打造了一个贴近真实开发场景的工业级评测基准。
由 GPT-5.4 合成 3 万 + 条 (query, skill) 对。为每个查询沿三条互补路径构造 10 个难负样本:语义相似(预计算 16K 技能 Embedding,余弦 Top-50 中采样 4 个)、词汇重叠(BM25 匹配 3 个)、同类别(3 个)。
针对技能库中不同名技能功能实际重叠的问题,对语义相似度 >90% 的候选使用 GPT-4o-min 二次校验并剔除假负样本,仅此一步 TopK@1 提升 4%。
在 10K 技能库下取得 81.0% Acc、0.869 MRR,较最强基线提升 +9.0 个百分点;在线推理平均延迟 97.7ms/query,较传统 LLM 路由方案提速 约 35 倍。
| 方法 | Emb | 50 | 500 | 1,000 | 5,000 | 10,000 | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Acc | MRR | Acc | MRR | Acc | MRR | Acc | MRR | Acc | MRR | ||
| Baseline | -- | 77.0% | -- | 75.0% | -- | 76.0% | -- | -- | -- | -- | -- |
| SkillRL | 0.6B | 90.0% | 0.953 | 89.0% | 0.906 | 85.0% | 0.891 | 74.0% | 0.837 | 68.0% | 0.745 |
| 4B | 91.0% | 0.937 | 86.0% | 0.954 | 86.0% | 0.893 | 70.0% | 0.728 | 62.0% | 0.770 | |
| 8B | 95.0% | 0.975 | 87.0% | 0.974 | 82.0% | 0.922 | 75.0% | 0.830 | 72.0% | 0.770 | |
| SkillRouter | 0.6B | 93.0% | 0.961 | 91.0% | 0.942 | 86.0% | 0.910 | 71.0% | 0.786 | 72.0% | 0.800 |
| 4B | 93.0% | 0.961 | 91.0% | 0.942 | 88.0% | 0.921 | 69.0% | 0.766 | 69.0% | 0.782 | |
| 8B | 93.0% | 0.961 | 91.0% | 0.941 | 88.0% | 0.917 | 71.0% | 0.778 | 69.0% | 0.790 | |
| Ours | 0.6B | 90.0% | 0.931 | 90.0% | 0.933 | 88.0% | 0.917 | 74.0% | 0.811 | 75.0% | 0.825 |
| 4B | 91.0% | 0.944 | 93.0% | 0.963 | 90.0% | 0.934 | 77.0% | 0.835 | 72.0% | 0.804 | |
| 8B | 87.0% | 0.929 | 92.0% | 0.956 | 89.0% | 0.929 | 77.0% | 0.846 | 79.0% | 0.852 | |
| FT-8B | 95.0% | 0.971 | 96.0% | 0.976 | 90.0% | 0.942 | 78.0% | 0.856 | 81.0% | 0.869 | |
主结果表保留了论文里的五个 Skill 库规模。可以直接看出:从 500 到 10,000 的所有规模下,FT-8B 都保持了最强的 Accuracy 与 MRR;随着技能库增大,图联合重排的退化曲线也更平缓。
单位:ms · 越低越好
| 方法 | Val Set | Mean | P50 | P95 | Retr. | Graph | Model | LLM | Rerank |
|---|---|---|---|---|---|---|---|---|---|
| Baseline | 50 | 4108.18 | 4038.69 | 5329.13 | — | — | — | 4107.64 | — |
| SkillRL | 50 | 4058.93 | 3298.17 | 5458.94 | 0.61 | — | — | 4057.76 | — |
| 500 | 3931.56 | 3951.96 | 5053.46 | 1.45 | — | — | 3929.75 | — | |
| 1,000 | 4332.23 | 4129.39 | 5206.77 | 1.28 | — | — | 4330.36 | — | |
| 5,000 | 4639.88 | 4516.57 | 6132.87 | 4.31 | — | — | 4632.44 | — | |
| 10,000 | 4392.15 | 4629.57 | 4972.23 | 10.17 | — | — | 4381.48 | — | |
| SkillRouter | 50 | 3375.62 | 3382.61 | 3547.96 | 0.70 | — | — | — | 3374.93 |
| 500 | 3284.69 | 3208.12 | 3515.04 | 1.55 | — | — | — | 3283.14 | |
| 1,000 | 3467.04 | 3428.91 | 3701.21 | 6.14 | — | — | — | 3460.90 | |
| 5,000 | 3342.08 | 3215.58 | 3621.17 | 4.03 | — | — | — | 3338.05 | |
| 10,000 | 3383.46 | 3433.33 | 3610.00 | 28.13 | — | — | — | 3355.33 | |
| Ours | 50 | 17.20 | 17.45 | 18.58 | 0.49 | 3.06 | 13.65 | — | — |
| 500 | 81.60 | 86.20 | 97.87 | 10.51 | 23.41 | 47.68 | — | — | |
| 1,000 | 87.22 | 92.74 | 93.55 | 10.05 | 31.49 | 45.68 | — | — | |
| 5,000 | 98.59 | 100.26 | 101.18 | 12.43 | 28.27 | 57.89 | — | — | |
| 10,000 | 97.74 | 97.74 | 123.18 | 10.73 | 32.09 | 54.92 | — | — |
Mean 为平均延迟,P50 / P95 为延迟分位数;后五列展示各阶段耗时,— 表示原表未报告该项。
当前 Agent 系统普遍将跨会话记忆以文本形式拼入上下文窗口,随记忆增长导致输入 Token 膨胀和 KV Cache 显存压力。本项目将长期记忆整体迁移到 LoRA 参数空间:通过 Hypernetwork 一次性将全部长期记忆直接生成 LoRA Adapter 并注入 Base Model,使记忆以参数化形式参与推理,不再每轮重复消费历史文本。
以长期记忆文本为输入,由预训练的 Hypernetwork 直接生成 LoRA 参数。生成时无需为每份记忆构造训练数据,也无需逐份微调。
将长期记忆送入冻结的 Context Encoder,提取各层的 Token 表示;较长记忆按块编码。
Hypernetwork 读取这些表示,通过前向计算生成目标层的 LoRA A/B 矩阵,将记忆映射为参数增量 ΔW。
将 LoRA 加载到冻结的 Base Model,结合当前 Query 与短期上下文作答,无需再次拼入原始长期记忆文本。
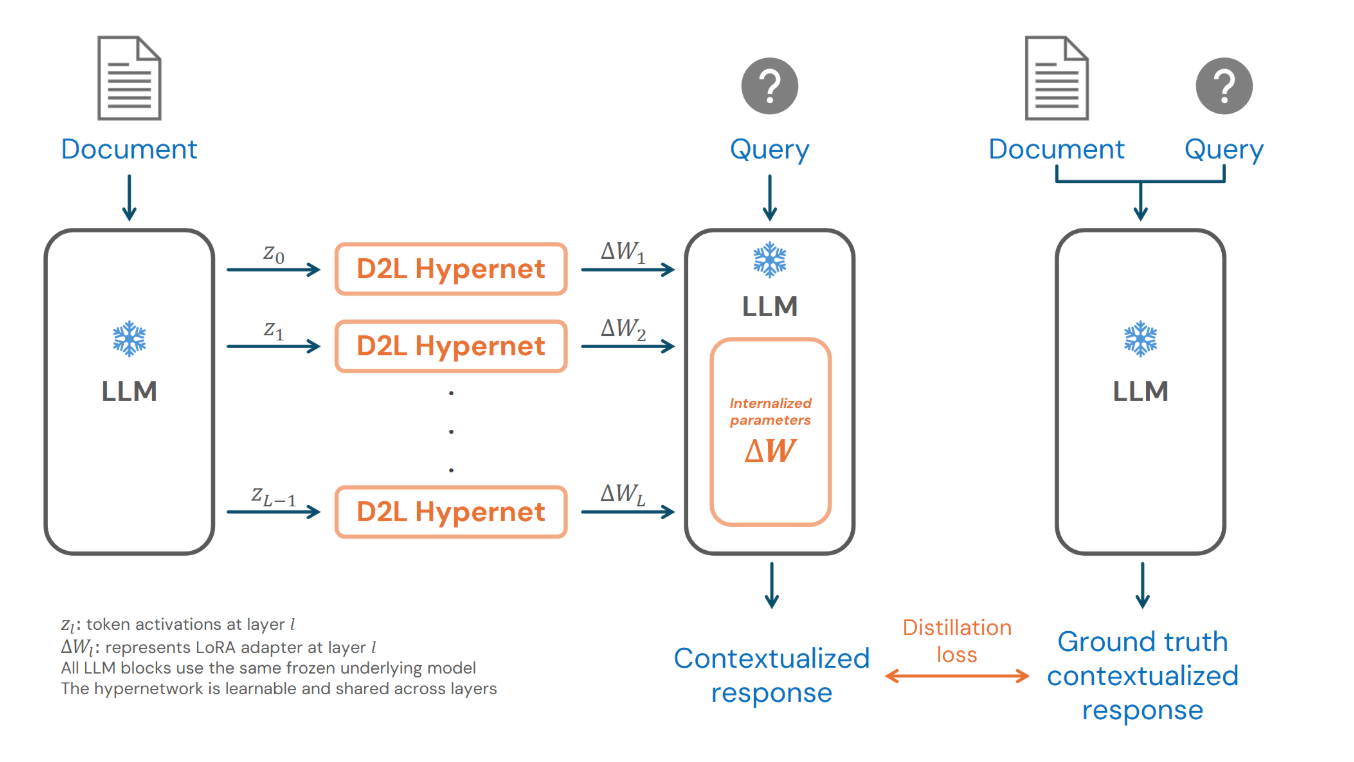
图中包含预训练过程。右侧教师模型通过蒸馏监督 Hypernetwork;实际使用时,仅执行左侧的记忆编码、参数生成与注入链路。
Architecture
将 Agent 记忆按生命周期划分为两条路径。
当前任务上下文、推理中间态、工具调用结果继续驻留在 Context 中维持实时感知,不参与参数化,优先保证实时、精确、可覆盖。
用户偏好、项目背景等稳定信息,由 Auto Memory 管理模块统一维护:调用后台 Subagent 提取记忆,调度参数化,并在请求时加载 LoRA 参与推理。
优先级当前用户指令 > 当前会话约束 > Session Summary > Active LoRA > Base Model 先验

Results
在长期记忆 Benchmark 上,这个项目最终回答的是一个非常具体的问题:对高复用、相对稳定的长期信息,是否值得从上下文路径迁移到参数化路径。
我更看重这组结果背后的结论:稳定、高复用、允许有损表达的长期信息,可以不再每轮都占用上下文窗口;而精确、时效、敏感信息仍然保留在文本 / RAG 路径里,两者并不是互斥关系。
传统文本记忆的优势在于可引用、可审计、易更新,但一旦跨会话记忆不断累积,输入 Token、Prefill 和 KV Cache 成本都会持续上升。参数化记忆的价值,则是把一次编译成本摊销到后续多轮推理里。
所以这个项目最终不是要“替代” RAG,而是把 Agent 长期记忆拆成两条更清晰的交付路径:稳定背景走参数,精确信息走文本,工程上各自发挥长处。
Visual reasoning
基于 Qwen2.5-VL-7B,将面部动作编码系统(FACS)引入表情识别。通过数据工程与 SFT + GRPO 两阶段全量微调,让模型先推理面部动作单元(AU),再给出情绪判断,形成具备“视觉归因”能力的情感计算模型。
Observe → Reason → Recognize
观察视觉线索
推理 AU 特征
结合推理过程
输出表情类别
FACS → CoT
Expert prior
FACS设计“反向推理”管线,注入先推理 AU 特征、后判定情绪的专家范式。
GPT-4o distillation
1.2万条 CoT构建含 <think> 标签的训练数据,解决逻辑推理冷启动问题。
Evaluation results
基线 Base
70.6%SFT 后
80.8%GRPO 后
81.1%缓解“中性幻觉”
改善长尾类别识别